Referenzarchitektur Frontend
Die Referenzarchitektur Frontend beschreibt die grundlegenden Rahmenbedingungen sowie die architekturellen Leitlinien für die Entwicklung des IT-Systemtyps Frontend in Anwendungen. Sie dient als verbindliche Grundlage für die Gestaltung und Umsetzung benutzerorientierter Komponenten im Kontext moderner Geschäftsanwendungen.

Wie in Einbettung Frontends in der fachlichen Referenzarchitektur dargestellt, erfolgt grundsätzlich eine Unterteilung der Geschäftsanwendung (GA) in zwei IT-Systeme: das Backend (GK) zur Bereitstellung fachlicher Logik und Services sowie das Frontend (GKGUI) als Benutzeroberfläche zur Interaktion mit dem Anwender.
Diese softwaretechnische Trennung erfolgt ausschließlich aus technologischen und organisatorischen Gründen: Frontend und Backend können unabhängig voneinander entwickelt, betrieben und skaliert werden und setzen in der Regel unterschiedliche Technologien sowie potenziell getrennte Entwicklungsteams ein. Aus Sicht der Anwender bleibt die Anwendung dabei weiterhin als einheitliches System wahrnehmbar.
Dieses Strukturprinzip gilt analog für Querschnittsanwendungen (QA), die entsprechend in QK (Backend) und QKGUI (Frontend) gegliedert werden.
Die Referenzarchitektur Frontend fokussiert sich auf die Beschreibung von Rahmenbedingungen und konzeptionellen Leitlinien für den IT-Systemtyp Frontend sowie dessen Interaktion mit anderen IT-Systemtypen, insbesondere dem Backend, zu dem aufgrund der Darstellung und Verarbeitung fachlicher Anwendungsfälle in der Regel eine enge funktionale Kopplung besteht.
1. Zielbild & Geltungsbereich
Geltungsbereich
-
Alle neu zu entwickelnden Frontends für Anwendungen (Standardsoftware ausgeschlossen)
-
Kürzlich entwickelte Bestandsanwendungen, die bereits als Single-Page Application umgesetzt wurden
-
Explizit ausgeschlossen sind alte Bestandsanwendungen, die noch auf Basis von JSF entwickelt wurden
Die unten beschriebenen Zielbilder sowie der Geltungsbereich der Referenzarchitektur Frontend konzentrieren sich auf die Bereitstellung von Frontends als Single-Page Applications. Geschäftsanwendungen in der öffentlichen Verwaltung sind überwiegend Business-Anwendungen, die auf die Verarbeitung von Daten sowie eine geringe Anzahl von Anwendern (Sachbearbeitern) ausgelegt sind. Anforderungen wie schnelle LCP (Largest Contentful Paint) oder Search Engine Optimization (SEO) haben keine hohe Priorität, sodass der Architekturstil Server-Side Rendering (SSR) zunächst ausgeklammert werden kann.
Auf Basis dieser Architekturvorgabe werden zwei konkrete Zielbilder besprochen: Single-Page Application (SPA) mit direkter Backend-Anbindung sowie die Architekturvariante mit Backend-for-Frontend (BFF).
1.1. Single-Page Application (SPA) mit direkter Backend-Anbindung
Darstellung der Frontends in der softwaretechnischen Architektur inklusive Security zeigt die softwaretechnische Darstellung von Frontends in einer Anwendungslandschaft. Im Vergleich zur allgemeinen Darstellung der softwaretechnischen Referenzarchitektur geht die folgende Abbildung näher auf die bereits in der Einführung erwähnte Verteilung von Frontend und Backend ein.

Durch die Verwendung von SPAs befindet sich der Frontend-Teil der GA im Webbrowser des Anwenders, während der Backend-Teil weiterhin auf den Servern der Anwendungslandschaft betrieben wird. Zur strukturierten, sicheren und einheitlichen Anbindung der Frontends an die Backend-Systeme ist verpflichtend, ein zentrales API-Gateway als querschnittliche Komponente vorzuschalten. Das API-Gateway ist ein Bestandteil der Systemlandschaft und wird in der software-technischen Referenzarchitektur detailliert beschrieben.
1.2. Architekturvariante mit Backend-for-Frontend (BFF)
Darstellung der Frontends in der softwaretechnischen Architektur mit der Variante BFF zeigt eine Variante für die Darstellung von SPAs in der softwaretechnischen Referenzarchitektur unter Verwendung eines Backend-for-Frontend (BFF).

Dabei wird eine zusätzliche Anwendung zwischen Backend und Frontend auf der Serverseite vorgesehen, um das Backend über eine spezifische API vom Frontend zu entkoppeln. Diese Vorgehensweise erhöht zunächst die Komplexität, ist jedoch ein bewährtes Muster, um folgende Herausforderungen zu lösen:
-
Auslieferung unterschiedlicher Darstellungen je nach Endgerät (Smartphone, Tablet, Desktop).
-
Umsetzung von Performance-, Sicherheits- oder Skalierbarkeitsanforderungen, die speziell für die Kommunikation zwischen Frontend und Backend relevant sind.
-
Vorverarbeitung, Filterung und Validierung sensibler oder sicherheitskritischer Daten im Backend, bevor sie an das Frontend gesendet werden – ohne die Backend-API für andere Dienste einschränken zu müssen.
1.3. Architekturvariante: Modularisierte Single Page Application mit Native Federation
Die Architekturvariante Native Federation beschreibt eine modularisierte Single Page Application (SPA), bei der fachlich abgegrenzte Anwendungsdomänen (z. B. „Suche“, „Fallbearbeitung“, „Administration“) als eigenständig lieferbare Frontend-Komponenten umgesetzt und zur Laufzeit durch eine zentrale Anwendungskomponente (Shell) integriert werden.
| Eine Shell-Anwendung ist die zentrale Anwendungskomponente innerhalb einer modularisierten Single Page Application. Sie stellt den technischen Rahmen der Anwendung bereit und integriert fachliche Frontend-Komponenten zur Laufzeit. |

Im Unterschied zu einer „einfachen“ SPA (ein Build-Artefakt, ein Deployment) erlaubt diese Variante getrennte Build- und Bereitstellungsprozesse je Komponente und reduziert damit Kopplungseffekte zwischen Organisationseinheiten und Liefergegenständen (Artefakten).
Die erhöhte Komplexität ist gerechtfertigt, wenn organisatorische oder technische Rahmenbedingungen eine Modularisierung erfordern; insbesondere dann, wenn mehrere Organisationseinheiten oder Auftragnehmer parallel an derselben Anwendung arbeiten und unabhängige Release-Zyklen bzw. Freigaben benötigt werden.
Native Federation ist sinnvoll, wenn mehrere der folgenden Entscheidungskriterien erfüllt sind:
-
Skalierung von Organisationseinheiten: Mindestens drei Teams (oder mehrere Dienstleister) entwickeln parallel an derselben Anwendung, und die zentrale Integration eines monolithischen Frontends führt zu Blockaden im Bereitstellungsprozess.
-
Unabhängige Freigaben: Fachliche Anwendungsdomänen müssen getrennt bereitgestellt werden (z. B. aufgrund unterschiedlicher Roadmaps, Abnahme- oder Freigabeprozesse bzw. Wartungsfenster).
-
Fachliche Modularisierbarkeit: Die Anwendung lässt sich entlang stabiler fachlicher Domänen strukturieren, ohne dauerhaft stark domänenübergreifenden UI-Zustand oder eng verflochtene Nutzungsszenarien zu erzwingen.
-
Governance- und Architekturvorgaben: Es bestehen verbindliche Regeln für Schnittstellen, Versionierung, Deprecation und Freigabeprozesse, um die kontrollierte Laufzeitintegration unabhängig bereitgestellter Frontend-Komponenten sicherzustellen. Ohne diese Architekturvorgaben besteht das Risiko von Laufzeitinkompatibilitäten und Beeinträchtigungen der Gesamtanwendung. Ein minimaler Rahmen umfasst:
-
Definition und Dokumentation von Integrationsschnittstellen,
-
verbindliche Versionierungsregeln (z. B. Semantic Versioning gemäß IsyFact-Versionierungskonzept),
-
geregelte Deprecation- und Übergangsfristen bei inkompatiblen Änderungen,
-
versionierte Einbindung externer Komponenten (keine ungebundenen „Latest“-Referenzen),
-
etablierte Freigabe- und Qualitätssicherungsprozesse vor produktiver Integration.
-
-
Betriebs- und Sicherheitsanforderungen: Sicherheits- und Supply-Chain-Kontrollen (z. B. kontrollierte Bezugsquellen, Nachvollziehbarkeit von Build-Artefakten) sowie etablierte Verfahren für Protokollierung, Monitoring und Nachvollziehbarkeit sind organisatorisch und technisch umgesetzt.
-
Testkonzept: Es existiert ein belastbares Testkonzept mit einer Kombination aus Schnittstellen- (Contract-)Tests und Integrations- bzw. Smoke-Tests, um die Kompatibilität zwischen Shell-Komponente und fachlichen Komponenten kontinuierlich sicherzustellen.
Sind diese Voraussetzungen nicht gegeben (z. B. nur ein bis zwei Teams, gemeinsamer Freigabezyklus, hohe funktionale Verflechtung), ist eine einfache SPA oder ein modular strukturierter Monolith (klare Modulgrenzen innerhalb eines gemeinsamen Build-Artefakts) in der Regel wirtschaftlicher und risikoärmer.
Native Federation ist somit kein Standardvorgehen, sondern eine gezielte Architekturentscheidung zur Skalierung von Organisation, Lieferfähigkeit und Modernisierungsfähigkeit bei großen, langfristig betriebenen Anwendungen.
2. Architekturgrundsätze & -regeln für Frontends
Dieses Kapitel beschreibt die übergreifenden Architekturgrundsätze und -regeln für die Gestaltung von Frontends im Geltungsbereich dieser Referenzarchitektur.
Die hier formulierten Grundsätze sind verbindlich und dienen als normative Leitplanken für alle neu zu entwickelnden Frontends sowie für relevante Weiterentwicklungen bestehender Anwendungen.
Ziel ist es, eine einheitliche, sichere, wartbare und langfristig evolvierbare Frontend-Landschaft sicherzustellen. Konkrete technische Ausprägungen und Detailvorgaben werden in den nachfolgenden Kapiteln behandelt.
2.1. Architekturgrundsätze
2.1.1. AG-1: Trennung von Frontend und Backend
Frontend und Backend MÜSSEN als eigenständige IT-Systemtypen mit klar abgegrenzten Verantwortlichkeiten konzipiert und betrieben werden. Diese Trennung SOLL eine unabhängige Entwicklung, den separaten Betrieb sowie eine evolvierbare Weiterentwicklung ermöglichen.
2.1.2. AG-2: Frontend als nicht vertrauenswürdige Komponente
Der IT-Systemtyp Frontend DARF NICHT als vertrauenswürdige Komponente betrachtet werden. Sicherheits- oder fachkritische Entscheidungen DÜRFEN NICHT im Frontend getroffen werden, sondern in Backend-Systemen.
2.1.3. AG-3: Standardisierung vor projektspezifischen Sonderlösungen
Die Gestaltung von Frontends SOLL einheitlichen architektonischen, technologischen und organisatorischen IsyFact-Standards des BVA folgen. Abweichungen MÜSSEN begründet und dokumentiert werden.
2.1.4. AG-4: Evolvierbarkeit und Austauschbarkeit
Frontend-Architekturen SOLLEN so gestaltet werden, dass technologische Weiterentwicklungen, der Austausch einzelner Komponenten sowie funktionale Erweiterungen mit vertretbarem Aufwand möglich sind
2.1.5. AG-5: Modularer Aufbau entlang fachlicher Verantwortlichkeiten
Frontends SOLLEN modular aufgebaut sein. Die Strukturierung SOLL sich primär an fachlichen Verantwortlichkeiten und Anwendungsdomänen orientieren, nicht ausschließlich an technischen Schichten.
2.1.6. AG-6: Einheitlicher Zugriff auf Backend-Systeme
Der Zugriff von Frontends auf Backend-Systeme SOLL einheitlich erfolgen. Hierfür SOLL ein zentrales API-Gateway als vermittelnde Komponente vorgesehen werden.
2.1.7. AG-7: Backend-for-Frontend als optionale Architekturvariante
Ein Backend-for-Frontend (BFF) SOLL als optionale Architekturvariante vorgesehen werden, wenn Anforderungen an Vorverarbeitung, Sicherheit, Performance oder Entkopplung zwischen Frontend und Backend bestehen.
2.1.8. AG-8: Security und Datenschutz by Design
Sicherheits- und Datenschutzanforderungen SOLLEN von Beginn an integraler Bestandteil der Frontend-Architektur sein. Personenbezogene Daten MÜSSEN auf das notwendige Minimum beschränkt und zweckgebunden verarbeitet werden.
2.1.9. AG-9: Modularisierung nur bei nachgewiesenem Bedarf
Eine Laufzeit-Modularisierung (z. B. via Native Federation) SOLL nur eingesetzt werden, wenn organisatorische oder fachliche Gründe dies erfordern (z. B. mehrere Teams/Lieferanten, unabhängige Release-Zyklen). Andernfalls SOLL eine einfache SPA oder ein modularer Monolith bevorzugt werden.
2.1.10. AG-10: Kontrollierte Runtime-Integration über Shell
Frontends, die aus mehreren unabhängig bereitgestellten Modulen bestehen (Native Federation), SOLLEN über eine zentrale Shell-Anwendung integriert werden. Die Shell SOLL ausschließlich Integrations- und Querschnittsaufgaben (z. B. Routing, Authentifizierung, Layout, Fehlerbehandlung) übernehmen; fachliche Logik SOLL in den Fachmodulen verbleiben.
2.1.11. AG-11: Verbindliche Integrationsverträge und Versionierung
Bei der Integration unabhängig deployter Frontend-Module über Native Federation MÜSSEN öffentliche Schnittstellen (Contracts) definiert, versioniert und über Deprecation-Regeln gesteuert werden. Die produktive Einbindung SOLL versiongebunden erfolgen (keine ungebundenen „Latest“-Referenzen), um Laufzeitinkompatibilitäten zu vermeiden.
4. Security & Compliance
Dieses Kapitel schärft die übergreifenden Sicherheitsvorgaben aus der Referenzarchitektur Sicherheit für den IT-Systemtyp Frontend. Es beschreibt ausschließlich frontend-spezifische Vorgaben; alle übergreifenden Prinzipien (Authentifizierung, Autorisierung, Zertifikate) sind in der Referenzarchitektur Sicherheit festgelegt und gelten uneingeschränkt.
Grundlage ist AG-2: Frontend als nicht vertrauenswürdige Komponente: Das Frontend DARF NICHT als vertrauenswürdige Komponente behandelt werden. Sämtliche sicherheits- und fachkritischen Entscheidungen MÜSSEN im Backend getroffen und dort validiert werden. Clientseitige Prüfungen dienen ausschließlich der Nutzerführung (UX), nicht der Sicherheitsdurchsetzung. Dies entspricht dem Zero-Trust-Prinzip für Frontends: Jede Anfrage an ein Backend-System trägt explizit Authentifizierungs- und Autorisierungsnachweise; implizites Vertrauen aufgrund des Netzwerkstandorts oder einer vorherigen Sitzung genügt nicht.
4.1. Authentifizierung & Token-Handling
Frontends authentifizieren Nutzer über den zentralen IAM-Service der Systemlandschaft. Die übergreifenden Vorgaben zu OAuth 2.0, IAM-Service und Autorisierungsinformationen sind in der Referenzarchitektur Sicherheit festgelegt. Die folgenden Vorgaben schärfen diese für SPAs.
4.2. HTTP-Sicherheits-Header & Cookies
HTTP-Response-Header sind die primäre Maßnahme des Browsers zum Schutz vor Clickjacking, Cross-Site-Scripting (XSS) und verwandten Angriffen. Sie MÜSSEN serverseitig gesetzt werden – entweder durch den Webserver/Reverse Proxy, der das Frontend ausliefert, oder durch ein vorgelagertes API-Gateway.
4.3. CORS & CSRF
CORS (Cross-Origin Resource Sharing) und CSRF-Schutz werden primär serverseitig (API-Gateway, Backend) durchgesetzt. Das Frontend MUSS dennoch folgende Vorgaben einhalten.
4.4. Transport-Sicherheit & Protokolle
Die übergreifenden Vorgaben zu TLS und Zertifikaten sind in der Referenzarchitektur Sicherheit normativ festgelegt. Die folgenden Vorgaben ergänzen diese für die Browser-Kommunikation.
4.5. Supply-Chain-Sicherheit
Build-Artefakte von Frontends bestehen typischerweise aus zahlreichen Open-Source-Abhängigkeiten und sind daher besonders Supply-Chain-Risiken ausgesetzt. Die nachfolgenden Vorgaben korrespondieren mit AG-11: Verbindliche Integrationsverträge und Versionierung (Versionsbindung) und den Betriebs- und Sicherheitsanforderungen aus der Architekturvariante: Modularisierte Single Page Application mit Native Federation.
4.6. XSS-Prävention im Code
Die in HTTP-Sicherheits-Header & Cookies definierten Header (insbesondere CSP) reduzieren die Auswirkungen von XSS, ersetzen jedoch keine sichere Implementierung im Anwendungscode.
4.7. Native Federation — Sicherheitsanforderungen
Bei Verwendung der Architekturvariante Native Federation (siehe Architekturvariante: Modularisierte Single Page Application mit Native Federation) werden zur Laufzeit Module aus separaten Bereitstellungen geladen. Daraus ergeben sich zusätzliche Sicherheitsanforderungen.
4.9. Datenschutz & Datenminimierung im Browser
Das Frontend verarbeitet im Browser personenbezogene Daten, die den Anforderungen der DSGVO (insbesondere Art. 5 Abs. 1 lit. c – Datenminimierung) unterliegen. Da keine übergreifenden IsyFact-Vorgaben zu DSGVO existieren, sind die konkreten datenschutzrechtlichen Anforderungen im Berechtigungs- und Datenschutzkonzept der jeweiligen Systemlandschaft zu regeln. Die folgenden Vorgaben definieren den technischen Mindestrahmen.
5. Qualitätssicherung
Dieses Kapitel beschreibt die verbindlichen Vorgaben zur Qualitätssicherung (QS) von Frontends im Geltungsbereich dieser Referenzarchitektur. Es konkretisiert AG-3: Standardisierung vor projektspezifischen Sonderlösungen (Standardisierung vor projektspezifischen Sonderlösungen) und AG-4: Evolvierbarkeit und Austauschbarkeit (Evolvierbarkeit und Austauschbarkeit) für die Bereiche Teststrategie, statische Codeanalyse und automatisierte Qualitätsprüfungen.
5.1. Ziele und Abgrenzung
-
Zielsetzung: nachvollziehbare, reproduzierbare und automatisiert prüfbare Qualität von Frontends über den gesamten Lebenszyklus – als Voraussetzung für Wartbarkeit, Sicherheit und Barrierefreiheit.
-
Werkzeugneutralität: Verbindlich sind ausschließlich die Qualitätsziele, Prüfkriterien und Quality Gates. Vorgaben werden daher als prüfbare Kriterien formuliert (z. B. „Testausführung MUSS automatisiert in der CI/CD-Pipeline erfolgen“), nicht als Werkzeugkonfiguration.
-
Werkzeugauswahl: Vorgegebene und empfohlene Produkte sind im Produktkatalog der IsyFact festgelegt – für Frontends insbesondere im Technologiestack Typescript/Angular; die Negativliste benennt untersagte Produkte. Innerhalb dieses Rahmens bleibt die Werkzeugwahl Projektentscheidung; Abweichungen vom Produktkatalog MÜSSEN begründet und dokumentiert werden (→ AG-3: Standardisierung vor projektspezifischen Sonderlösungen).
-
Alle in diesem Kapitel genannten Werkzeuge sind Beispiele zur Veranschaulichung der technischen Machbarkeit und haben keinen normativen Charakter.
-
Abgrenzung: Sicherheitsprüfungen der Lieferkette (Dependency-, Secret-Scanning, SBOM) sind bereits in Supply-Chain-Sicherheit geregelt und werden hier nur als Quality Gate referenziert, nicht erneut beschrieben.
5.2. Grundsätze der Qualitätssicherung
-
Shift Left: Qualitätsprüfungen SOLLEN so früh wie möglich greifen (lokal in der Entwicklungsumgebung, spätestens im Pull Request) statt erst in der Abnahme.
-
Automatisierung vor manueller Prüfung: Jede wiederholbare Prüfung MUSS automatisiert und in der CI/CD-Pipeline verankert sein; manuelle Tests bleiben auf explorative und fachliche Abnahmetests beschränkt.
-
Verbindlichkeit statt Empfehlung: Verletzte Quality Gates führen zum Abbruch der Pipeline; Ausnahmen MÜSSEN begründet, befristet und dokumentiert werden.
-
Qualität ist Teamverantwortung: QS ist integraler Bestandteil der Definition of Done und nicht an eine nachgelagerte Testphase delegierbar.
-
Frontend-spezifische Risiken: Da das Frontend gemäß AG-2: Frontend als nicht vertrauenswürdige Komponente nicht vertrauenswürdig ist, ersetzen Frontend-Tests keine serverseitige Validierung; sie sichern Darstellung, Bedienbarkeit und Integration ab.
5.3. Teststrategie für Frontends
Die Teststrategie legt fest, welche Eigenschaften eines Frontends auf welcher Teststufe abgesichert werden. Leitgedanke ist eine risikoorientierte Verteilung der Testfälle: Ein Fehler SOLL auf der niedrigsten Teststufe gefunden werden, auf der er feststellbar ist.
Die Teststufen unterscheiden sich in Realitätsnähe und Kosten: Je höher die Stufe, desto aussagekräftiger ist das Ergebnis, desto langsamer, störanfälliger und wartungsintensiver ist der Test jedoch auch. Eine Konzentration auf hohe Teststufen – insbesondere auf End-to-End-Tests – führt zu langen Rückmeldezeiten, instabilen Testläufen und hohen Wartungskosten und widerspricht dem Grundsatz Shift Left (siehe Grundsätze der Qualitätssicherung). Umgekehrt ersetzt eine hohe Abdeckung auf niedrigen Teststufen nicht den Nachweis, dass die Anwendung als Ganzes bedienbar ist.
Die Verteilung ist kein Selbstzweck, sondern folgt dem fachlichen Risiko: Fachlich kritische Geschäftsvorfälle MÜSSEN durchgängig über alle Stufen abgesichert sein, während unkritische Oberflächenbereiche auf den unteren Stufen abgedeckt werden können.
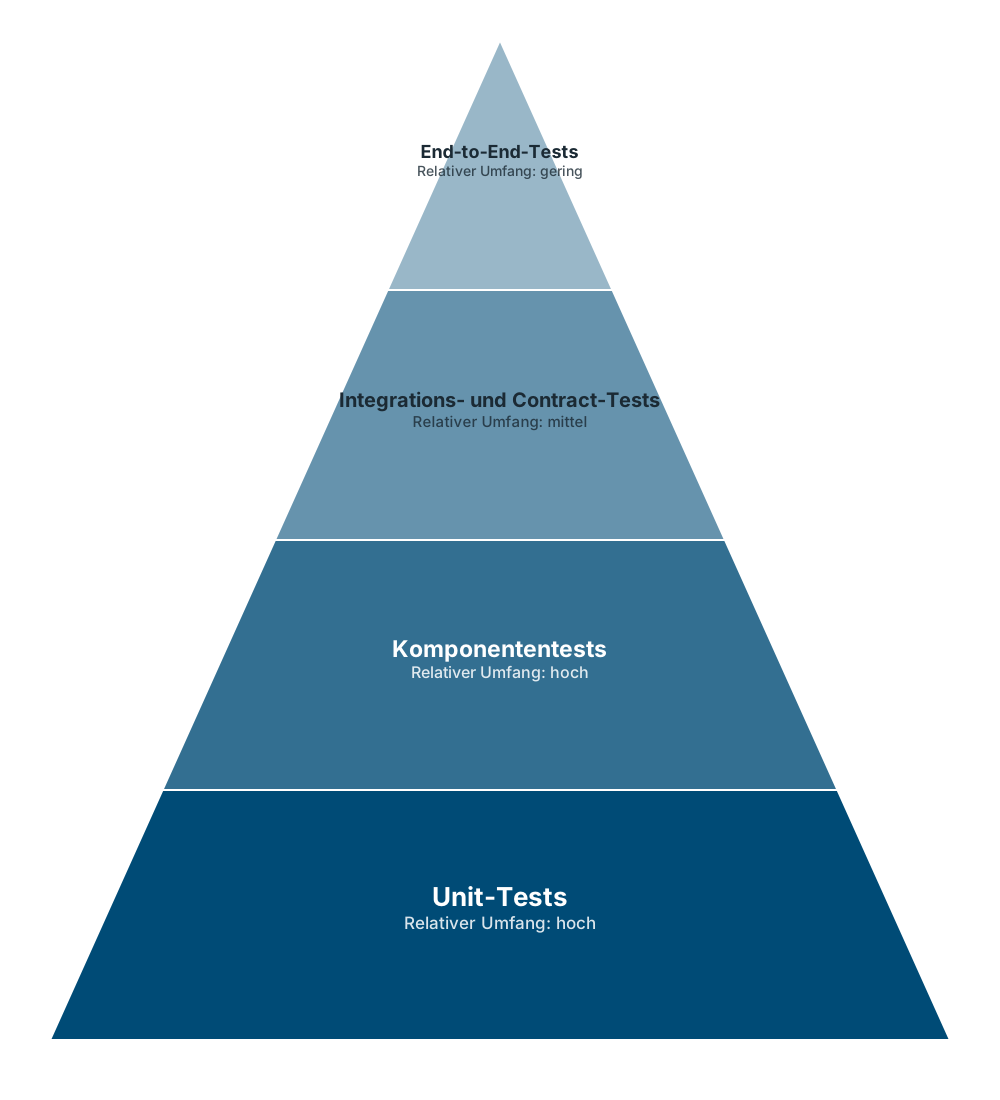
Teststufen der Frontend-Teststrategie beschreibt die Teststufen der Pyramide von der Basis bis zur Spitze.
| Teststufe | Prüfgegenstand | Abgrenzung und Testumgebung | Relativer Umfang | Quality Gate |
|---|---|---|---|---|
Unit-Tests |
Isolierte Logik ohne Oberflächenbezug: Services, Pipes, Utilities, Validierungen, Zustandsübergänge |
Ohne DOM- und Netzwerkabhängigkeit; Fremdsysteme werden konsequent über Testdoubles ersetzt |
hoch |
|
Komponententests |
UI-Komponenten inkl. Rendering, Eingabeverarbeitung, Ereignisbehandlung und Darstellung von Zuständen |
Gerendertes Komponenten-DOM ohne echtes Backend; Interaktion SOLL über nutzerzentrierte Selektoren (Rollen, Beschriftungen) statt über Implementierungsdetails erfolgen |
hoch |
|
Integrations- und Contract-Tests |
Zusammenspiel mehrerer Komponenten sowie die Backend-Anbindung gegen die vereinbarte Schnittstelle |
Reale HTTP-Schicht gegen einen aus der OpenAPI-Spezifikation abgeleiteten Mock- bzw. Contract-Server (siehe REST-Vorgaben), damit Schnittstellenänderungen im Build und nicht erst zur Laufzeit auffallen |
mittel |
|
End-to-End-Tests |
Fachlich kritische Nutzerpfade über Komponentengrenzen hinweg, inklusive Authentifizierung und Autorisierung gegen den IAM-Service |
Ausgelieferte Anwendung im realen Browser gegen eine produktionsnahe Umgebung; Tests MÜSSEN deterministisch und unabhängig von Testdatenreihenfolgen ablaufen |
gering |
5.3.1. Nicht-funktionale Tests
Neben der fachlichen Korrektheit MÜSSEN Frontends auch hinsichtlich ihrer nicht-funktionalen Eigenschaften abgesichert werden. Diese Eigenschaften sind für Nutzende unmittelbar erfahrbar und lassen sich nachträglich meist nur mit hohem Aufwand korrigieren, da sie strukturelle Änderungen an bereits abgenommenen Oberflächen erfordern.
Die folgenden Prüfungen SOLLEN daher fester Bestandteil der automatisierten Testausführung sein und nicht als nachgelagerte Sonderaktivität behandelt werden. Sie ergänzen die Teststufen aus Teststufen der Frontend-Teststrategie und werden auf denselben Stufen ausgeführt.
-
Performance: Messung und Budgetierung von Bundle-Größen und Ladezeiten; Überschreitungen definierter Budgets SOLLEN die Pipeline verletzen.
-
Sicherheit: Automatisierte statische Sicherheitsanalyse (SAST) des Frontend-Codes zur Erkennung unsicherer Muster gemäß XSS-Prävention im Code, insbesondere direkter DOM-Manipulation sowie der bewussten Umgehung der Framework-eigenen Sanitisierung.
-
Kompatibilität: Nachweis der Lauffähigkeit auf den für die Anwendung freigegebenen Browsern und Browser-Versionen.
-
Barrierefreiheit: Automatisierte Prüfung der maschinell entscheidbaren Kriterien (u. a. Alternativtexte, Label-Zuordnung, ARIA-Attribute, Kontrastwerte) auf Komponenten- und Seitenebene. Automatisierte Prüfungen decken nur einen Teil der Anforderungen ab; sie ersetzen weder die manuelle Prüfung noch eine formale Konformitätsbewertung (siehe UX, UI & Accessibility).
5.3.2. Besonderheiten modularisierter Frontends
Wird ein Frontend gemäß AG-9: Modularisierung nur bei nachgewiesenem Bedarf als modularisierte Anwendung mit Native Federation umgesetzt, verschiebt sich das zentrale Qualitätsrisiko: Die einzelnen Fachmodule werden unabhängig voneinander gebaut und bereitgestellt, treffen aber erst zur Laufzeit in der Shell-Anwendung aufeinander.
Fehler entstehen dadurch typischerweise nicht innerhalb eines Moduls, sondern an dessen Integrationsgrenzen – und werden von den QS-Maßnahmen eines einzelnen Moduls systematisch nicht erfasst. Die Teststrategie MUSS daher um eine übergreifende Absicherung des Zusammenspiels ergänzt werden.
-
Bei Native Federation MÜSSEN die Integrationsverträge zwischen Shell und Fachmodulen durch Contract-Tests abgesichert werden (→ AG-11: Verbindliche Integrationsverträge und Versionierung).
-
Jede Frontend-Komponente durchläuft eine eigenständige QS-Pipeline; zusätzlich SOLL eine übergreifende Integrations- bzw. Smoke-Test-Stufe die Lauffähigkeit des Komposits nachweisen.
-
Versionswechsel eines Fachmoduls MÜSSEN vor produktiver Integration gegen die aktuell produktive Shell-Version verifiziert werden.
-
Bei Einsatz eines Backend-for-Frontend (BFF) gelten für dessen serverseitigen Anteil zusätzlich die QS-Vorgaben der Referenzarchitektur Backend.
5.4. Statische Codeanalyse und Coding Standards
Die statische Codeanalyse prüft den Quellcode ohne Ausführung der Anwendung gegen ein definiertes Regelwerk. Sie ist die kostengünstigste Qualitätsmaßnahme überhaupt, da sie unmittelbar an der Codestelle Rückmeldung gibt – bereits in der Entwicklungsumgebung und damit lange vor jeder Testausführung.
Ihr Zweck ist zweigeteilt: Sie sichert die Einheitlichkeit des Codes über Teams und Auftragnehmer hinweg (→ AG-3: Standardisierung vor projektspezifischen Sonderlösungen) und erkennt zugleich fehleranfällige oder sicherheitskritische Muster, die durch Tests nur schwer aufzudecken sind.
-
Verbindliche Grundlage sind die TypeScript-Programmierkonventionen der IsyFact inklusive der dort referenzierten öffentlichen Regelsets.
-
Das isy-eslint-plugin SOLL als Basis-Regelset für die statische Codeanalyse eingebunden werden; Abweichungen sind im Quellcode zu begründen und zu dokumentieren.
-
Ergänzend SOLL ein template-fähiges Regelset eingebunden werden, um Barrierefreiheits- und Sicherheitsprüfungen im Template abzudecken.
-
Einheitliche Formatierung SOLL werkzeuggestützt und automatisiert sichergestellt werden (z. B. über das isy-prettier-plugin), um formatbedingtes Diff-Rauschen in Reviews zu vermeiden.
-
Statische Codeanalyse SOLL als Pflichtschritt der CI/CD-Pipeline ausgeführt werden; Regelverstöße der Kategorie „Fehler“ führen zum Build-Abbruch.
-
Ergänzend SOLL eine statische Sicherheitsanalyse (Static Application Security Testing, SAST) erfolgen: die werkzeuggestützte Prüfung des Quellcodes auf sicherheitskritische Muster ohne Ausführung der Anwendung.
5.5. Quality Gates
Ein Quality Gate ist ein definierter Prüfpunkt im Entwicklungs- und Auslieferungsprozess, an dem ein Artefakt festgelegte Kriterien erfüllen MUSS, um die nächste Stufe zu erreichen.
Quality Gates überführen die in den vorangegangenen Abschnitten beschriebenen Einzelmaßnahmen in eine verbindliche Reihenfolge: Sie legen fest, wann eine Prüfung stattfindet, wer oder was sie ausführt und welche Konsequenz ein Verstoß hat.
-
Gates werden als Kriterien beschrieben (Schwellwerte, Pflichtprüfungen, Nachweise), nicht als Werkzeugkonfiguration – die technische Umsetzung liegt beim Projekt.
-
Jede automatisierbare Prüfung eines Gates MUSS automatisiert und blockierend implementiert sein; ein nicht bestandenes Gate DARF NICHT übergangen werden.
-
Prüfungen SOLLEN am frühestmöglichen Gate stattfinden und auf späteren Gates nur wiederholt werden, wenn die neue Stufe zusätzliche Erkenntnis liefert (z. B. produktionsnahe Konfiguration).
-
Ausnahmen MÜSSEN als befristete, begründete und freigegebene Abweichung dokumentiert werden.
5.5.1. Einordnung in den Auslieferungsprozess
Die Quality Gates orientieren sich am Weg einer Änderung vom Entwicklungsrechner bis in die Produktivumgebung. Maßgeblich ist dabei nicht die konkrete Werkzeugkette, sondern die Stufe im Prozess: Quellcode-Verwaltung, Build und Paketierung, Ablage im Artefakt-Repository sowie die aufeinanderfolgenden Zielumgebungen.
Frontends werden als Bundle statischer Auslieferungsartefakte gebaut und über einen Webserver ausgeliefert. Daraus folgt ein zentrales Prinzip:
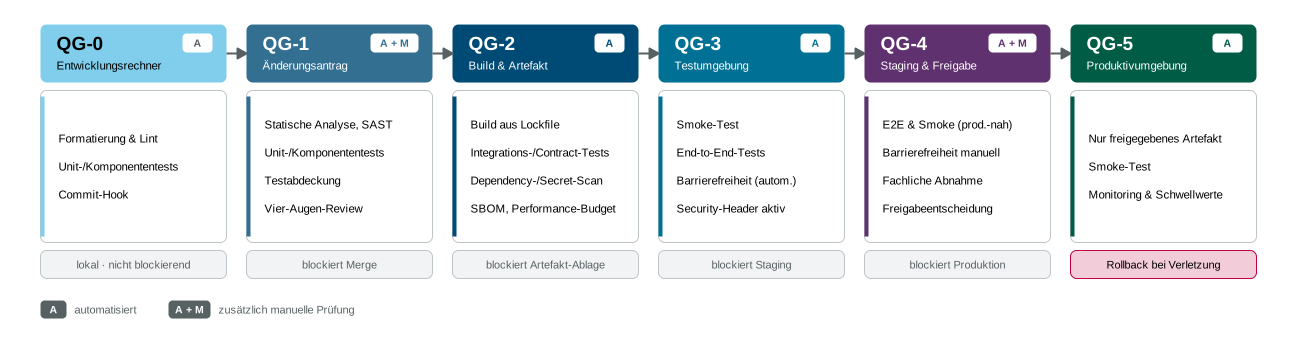
Übersicht der Quality Gates ordnet die Gates den Prozessstufen zu.
| Gate | Stufe im Prozess | Auslöser | Ausführung und Wirkung |
|---|---|---|---|
Entwicklungsrechner |
Speichern bzw. Erstellen eines Commits |
Automatisiert und lokal; nicht pipelineblockierend, aber Voraussetzung für ein zügiges Bestehen von QG-1 |
|
Quellcode-Verwaltung |
Erstellen oder Aktualisieren eines Änderungsantrags (Merge bzw. Pull Request) |
Automatisiert, ergänzt um ein manuelles Review; blockiert die Übernahme in den Integrationszweig |
|
Build, Paketierung und Artefakt-Repository |
Übernahme in den Integrationszweig |
Vollautomatisiert; blockiert die Ablage des Bundles im Artefakt-Repository |
|
Testumgebung |
Auslieferung des Bundles auf die Testumgebung |
Vollautomatisiert; blockiert die Weitergabe an die Staging-Umgebung |
|
Staging-Umgebung |
Auslieferung des Bundles auf die produktionsnahe Umgebung |
Automatisiert, ergänzt um manuelle Prüfungen; blockiert die Freigabe für die Produktion |
|
Produktivumgebung |
Auslieferung des freigegebenen Bundles in die Produktion |
Vollautomatisiert; löst bei Verletzung ein Rollback aus |
5.5.2. Zuordnung der Prüfungen zu den Quality Gates
Prüfungen je Quality Gate zeigt, an welcher Stelle des Prozesses eine Prüfung optimalerweise ausgeführt wird und ob sie automatisiert oder manuell erfolgt. Die Zuordnung folgt dem Grundsatz, jede Prüfung so früh wie möglich auszuführen und später nur dann zu wiederholen, wenn die höhere Stufe zusätzliche Aussagekraft besitzt.
| Prüfung | Art | QG-0 | QG-1 | QG-2 | QG-3 | QG-4 | QG-5 |
|---|---|---|---|---|---|---|---|
Formatierung und statische Codeanalyse |
A |
○ |
● |
– |
– |
– |
– |
Statische Sicherheitsanalyse (SAST) |
A |
○ |
● |
– |
– |
– |
– |
Unit- und Komponententests |
A |
○ |
● |
● |
– |
– |
– |
Testabdeckung geänderter Codezeilen |
A |
– |
● |
– |
– |
– |
– |
Fachliches Review (Vier-Augen-Prinzip) |
M |
– |
● |
– |
– |
– |
– |
Reproduzierbarer Build aus dem Lockfile |
A |
– |
– |
● |
– |
– |
– |
Integrations- und Contract-Tests |
A |
– |
○ |
● |
– |
– |
– |
Dependency- und Secret-Scanning, SBOM |
A |
– |
○ |
● |
– |
● |
– |
Performance-Budget (Bundle-Größe) |
A |
– |
– |
● |
– |
– |
– |
Barrierefreiheit, automatisiert |
A |
○ |
● |
– |
● |
– |
– |
End-to-End-Tests |
A |
– |
– |
– |
● |
● |
– |
Smoke-Test nach Auslieferung |
A |
– |
– |
– |
● |
● |
● |
Sicherheitsrelevante Auslieferungskonfiguration |
A |
– |
– |
– |
● |
● |
● |
Barrierefreiheit, manuell |
M |
– |
– |
– |
– |
● |
– |
Fachliche Abnahme |
M |
– |
– |
– |
– |
● |
– |
Freigabeentscheidung |
M |
– |
– |
– |
– |
● |
– |
Überwachung nach Auslieferung |
A |
– |
– |
– |
– |
– |
● |
Legende: ● verbindlich · ○ inkrementell bzw. auf den geänderten Umfang beschränkt · – nicht vorgesehen · A automatisiert · M manuell
5.5.3. QG-0: Entwicklungsrechner
Ausführung: automatisiert, lokal. Dieses Gate blockiert die Pipeline nicht, verlagert aber den Großteil der Rückmeldung von Minuten auf Sekunden und setzt Grundsätze der Qualitätssicherung („Shift Left“) praktisch um.
-
Formatierung und statische Codeanalyse inkrementell in der Entwicklungsumgebung, unmittelbar an der Codestelle.
-
Unit- und Komponententests des bearbeiteten Moduls vor Erstellung eines Commits.
-
Die Prüfungen SOLLEN über einen automatisierten Mechanismus (z. B. einen Commit-Hook) ausgelöst werden, damit sie nicht von der Disziplin Einzelner abhängen.
-
Die lokal ausgeführten Prüfungen MÜSSEN denselben Regelstand verwenden wie die Pipeline, damit lokale und zentrale Ergebnisse nicht auseinanderlaufen.
5.5.4. QG-1: Änderungsantrag
Ausführung: automatisiert, ergänzt um ein manuelles Review. Dieses Gate entscheidet über die Übernahme einer Änderung in den Integrationszweig und ist der letzte Punkt, an dem eine Änderung ohne Folgekosten korrigiert werden kann.
-
Statische Codeanalyse und Formatierungsprüfung ohne Regelverstöße der Kategorie „Fehler“.
-
Erfolgreiche Ausführung aller Unit- und Komponententests des betroffenen Moduls.
-
Einhaltung eines projektweit definierten Mindestwerts für die Testabdeckung geänderter Codezeilen.
-
Keine neu eingeführten Verstöße gegen die automatisiert prüfbaren Barrierefreiheitskriterien.
-
Erfolgreiches Vier-Augen-Review inklusive Prüfung auf Einhaltung der Architekturgrundsätze und -regeln dieses Kapitels.
5.5.5. QG-2: Build und Artefakterzeugung
Ausführung: vollautomatisiert. Dieses Gate erzeugt das unveränderliche Artefakt, das alle weiteren Stufen durchläuft; nicht bestandene Prüfungen verhindern dessen Ablage im Artefakt-Repository.
-
Reproduzierbarer Build ausschließlich auf Basis des Lockfiles (→ Supply-Chain-Sicherheit).
-
Erfolgreiche Ausführung der Integrations- und Contract-Tests gegen die spezifizierten Backend-Schnittstellen.
-
Bestandene Sicherheitsprüfungen: Dependency Scanning, Secret Scanning und SBOM-Erstellung gemäß Supply-Chain-Sicherheit.
-
Einhaltung der definierten Performance-Budgets (u. a. Bundle-Größe).
-
Das Artefakt MUSS eindeutig versioniert abgelegt und mit den zugehörigen Qualitätsnachweisen verknüpft werden.
5.5.6. QG-3: Testumgebung
Ausführung: vollautomatisiert. Erstmals wird nicht der Quellcode, sondern das tatsächlich ausgelieferte Bundle im Zusammenspiel mit Webserver und echten Backend-Schnittstellen geprüft.
-
Smoke-Test unmittelbar nach der Auslieferung: Erreichbarkeit der Anwendung sowie korrektes Laden der umgebungsspezifischen Konfiguration.
-
Erfolgreiche Ausführung der End-to-End-Tests für die als kritisch klassifizierten Nutzerpfade.
-
Automatisierte Barrierefreiheitsprüfung im realen Browserkontext, einschließlich dynamischer Zustände wie Dialogen, Fehlermeldungen und Fokusverwaltung nach Navigation.
-
Nachweis, dass die sicherheitsrelevante Auslieferungskonfiguration des Webservers aktiv ist (insbesondere die HTTP-Sicherheits-Header gemäß HTTP-Sicherheits-Header & Cookies).
5.5.7. QG-4: Staging-Umgebung und Freigabe
Ausführung: automatisiert, ergänzt um manuelle Prüfungen. Dieses Gate ist der einzige Punkt mit verpflichtenden manuellen Prüfungen und schließt mit einer dokumentierten Freigabeentscheidung ab.
-
Wiederholung der End-to-End- und Smoke-Tests unter produktionsnaher Konfiguration.
-
Manuelle Barrierefreiheitsprüfung für neue oder wesentlich geänderte Oberflächen (Tastaturbedienung, Screenreader-Ausgabe, Kontrast, Zoom).
-
Manuelle fachliche Abnahme der umgesetzten Anforderungen.
-
Erneute Schwachstellenbewertung des Artefakts zum Freigabezeitpunkt, da nach QG-2 neue Schwachstellen bekannt geworden sein können.
-
Vollständige und archivierte Qualitätsnachweise (Testberichte, Analyseergebnisse, SBOM) für das freizugebende Artefakt.
-
Keine offenen kritischen Befunde; verbleibende Befunde MÜSSEN bewertet, dokumentiert und freigegeben sein.
5.5.8. QG-5: Produktivumgebung
Ausführung: vollautomatisiert. Dieses Gate stellt sicher, dass ausschließlich das geprüfte Artefakt produktiv geht und eine fehlerhafte Auslieferung erkannt und zurückgenommen wird.
-
Es DARF ausschließlich die in QG-4 freigegebene, unveränderte Artefaktversion ausgeliefert werden.
-
Smoke-Test unmittelbar nach der Auslieferung; ein Fehlschlag MUSS ein Rollback auf die zuvor produktive Version auslösen.
-
Nachweis der aktiven sicherheitsrelevanten Auslieferungskonfiguration in der Produktivumgebung.
-
Überwachung von Fehlerraten und Verfügbarkeit über ein definiertes Zeitfenster nach der Auslieferung (→ Logging, Monitoring & Telemetrie); die Schwellwerte für ein Rollback MÜSSEN vorab festgelegt sein.
5.6. Nachweisführung und Qualitätsmetriken
-
Ergebnisse aller Quality Gates MÜSSEN maschinenlesbar erzeugt, versioniert und dem jeweiligen Build-Artefakt eindeutig zugeordnet archiviert werden.
-
Als Mindestmetriken SOLLEN erhoben werden: Testabdeckung, Anzahl und Schweregrad statischer Befunde, Anzahl offener Schwachstellen sowie Barrierefreiheits- und Performance-Befunde.
-
Metriken SOLLEN im Zeitverlauf beobachtet werden; eine Verschlechterung gegenüber dem letzten Release MUSS bewertet und begründet werden.
-
Qualitätsziele und Schwellwerte MÜSSEN projektspezifisch festgelegt und in der Systemdokumentation nachvollziehbar dokumentiert werden.
-
Nachweise MÜSSEN für Audits und Freigabeprozesse revisionssicher verfügbar sein.
7. Daten & Zustandsmanagement
Dieses Kapitel beschreibt verbindliche Leitlinien für den Umgang mit Daten, Zustand und clientseitigem Caching in Frontends. Ziel ist es, Frontends wartbar, sicher und nachvollziehbar zu gestalten und gleichzeitig unnötige Komplexität durch überdimensioniertes State Management zu vermeiden.
Der Zustand eines Frontends ist grundsätzlich als abgeleiteter Zustand zu betrachten. Fachlich verbindliche Daten, Berechtigungen und sicherheitsrelevante Entscheidungen MÜSSEN im Backend bzw. in den dafür vorgesehenen serverseitigen Komponenten verbleiben. Das Frontend DARF Daten lediglich darstellen, für die Benutzerinteraktion vorbereiten, temporär zwischenspeichern oder zur Verbesserung der Bedienbarkeit verwenden.
7.1. Grundsätze
Frontends SOLLEN ihren Zustand bewusst und nachvollziehbar modellieren. Dabei SOLL zwischen lokalem UI-Zustand, fachlichem Feature-Zustand, globalem Anwendungszustand, URL-/Navigationszustand und serverseitig geladenen Daten unterschieden werden.
Lokaler UI-Zustand, zum Beispiel geöffnete Panels, aktive Tabs, Eingabefokus oder temporäre Formularwerte, SOLL möglichst nah an der jeweiligen Komponente gehalten werden. Feature-Zustand, der von mehreren Komponenten innerhalb eines fachlichen Bereichs benötigt wird, SOLL in einem fachlich abgegrenzten Service oder Store gekapselt werden. Globaler Anwendungszustand SOLL nur verwendet werden, wenn ein Zustand tatsächlich von mehreren fachlichen Bereichen benötigt wird oder querschnittliche Bedeutung hat.
Serverseitig geladene Daten SOLLEN nicht unnötig in globalen Stores dupliziert werden. Für API-Daten ist zu prüfen, ob ein einfacher, fachlich begrenzter Cache ausreichend ist. Abgeleiteter Zustand SOLL nicht dauerhaft gespeichert werden, sondern aus dem eigentlichen Quellzustand berechnet werden.
7.2. State-Modelle
State-Modelle SOLLEN fachlich verständlich, typisiert und möglichst klein gehalten werden. Sie SOLLEN nur die Daten enthalten, die für die jeweilige Darstellung oder Interaktion notwendig sind.
Data Transfer Objects (DTOs) aus Backend-Schnittstellen SOLLEN nicht unreflektiert als internes Frontend-State-Modell verwendet werden. Bei Bedarf SOLL eine Trennung zwischen Schnittstellenmodell, fachlichem View-Modell und UI-Zustand erfolgen. Dadurch bleiben Änderungen an Backend-Schnittstellen besser beherrschbar und die Darstellungsschicht wird nicht unnötig an technische Datenstrukturen gekoppelt.
Gemeinsam genutzter Zustand SOLL nur über definierte Schnittstellen geändert werden. Komponenten SOLLEN gemeinsamen Zustand nicht direkt manipulieren, sondern dafür vorgesehene Methoden eines Services, Stores oder einer Fassade verwenden. Dadurch bleiben Zustandsänderungen nachvollziehbar und testbar.
Für Zustandsänderungen gelten folgende Vorgaben:
-
Zustandsänderungen SOLLEN explizit und nachvollziehbar erfolgen.
-
Gemeinsam genutzter Zustand SOLL nicht unkontrolliert aus beliebigen Komponenten verändert werden.
-
Abgeleiteter Zustand SOLL berechnet und nicht redundant gespeichert werden.
-
Zustände SOLLEN so modelliert werden, dass sie testbar sind.
-
Fehler-, Lade- und Leerzustände SOLLEN explizit berücksichtigt werden.
-
Fachliche Validierung und Autorisierung MÜSSEN serverseitig erfolgen.
Zustand, der für Navigation, Wiederherstellbarkeit oder Teilbarkeit relevant ist, SOLL bevorzugt in der URL abgebildet werden, zum Beispiel Suchparameter, Filter, Sortierung oder Pagination. Dadurch bleiben Ansichten nachvollziehbar, bookmarkfähig und leichter testbar. Sensible Daten DÜRFEN dabei nicht in URL-Parametern abgelegt werden.
7.3. Caching
Clientseitiges Caching DARF nur als Performance- und Bedienbarkeitsoptimierung verstanden werden. Der Cache DARF NICHT als fachlich verbindliche Datenquelle betrachtet werden.
Caching SOLL gezielt und fachlich begründet eingesetzt werden. Für zwischengespeicherte Daten MÜSSEN Gültigkeit, Invalidierung und Aktualisierung geregelt sein. Insbesondere bei personenbezogenen oder berechtigungsabhängigen Daten ist sicherzustellen, dass keine veralteten oder unzulässigen Daten angezeigt werden.
Für clientseitiges Caching gelten folgende Vorgaben:
-
Caches SOLLEN fachlich abgegrenzt und möglichst klein gehalten werden.
-
Cache-Einträge SOLLEN eine definierte Gültigkeit besitzen.
-
Caches MÜSSEN bei Benutzerwechsel, Logout oder Berechtigungsänderungen invalidiert werden.
-
Fehlerhafte oder unvollständige Antworten DÜRFEN NICHT ungeprüft als gültiger Cache-Zustand übernommen werden.
-
Berechtigungsabhängige Daten DÜRFEN NICHT benutzerübergreifend wiederverwendet werden.
-
Caching von sensiblen Daten MUSS begründet und durch geeignete Schutzmaßnahmen abgesichert werden.
-
HTTP-Cache-Vorgaben des Backends, insbesondere
Cache-Control, SOLLEN berücksichtigt werden.
Offline-Fähigkeit oder persistentes Caching fachlicher Daten ist eine eigene Architekturentscheidung. Sie DARF nur umgesetzt werden, wenn Anforderungen, Sicherheitsbetrachtung, Datenschutz, Synchronisation, Konfliktbehandlung und Löschkonzept beschrieben sind.
7.4. Speicherung von Daten im Client
Die Speicherung von Daten im Browser ist restriktiv zu verwenden. Grundsätzlich SOLL Zustand nur im Arbeitsspeicher gehalten werden. Persistente Speicherung im Client SOLL nur erfolgen, wenn sie fachlich oder technisch notwendig ist.
Folgende Einordnung ist zu verwenden:
| Speicherort | Geeignete Verwendung | Einschränkungen |
|---|---|---|
Arbeitsspeicher |
Lokaler UI-Zustand, temporärer Feature-Zustand, nicht persistenter Cache |
Standardfall für Frontend-State; Daten gehen bei Reload verloren |
URL |
Navigation, Filter, Sortierung, Pagination, wiederherstellbare Ansichten |
Keine sensiblen Daten; URLs können protokolliert, geteilt oder im Browser-Verlauf gespeichert werden |
|
Kurzlebige, nicht sensible Daten für eine Browser-Session oder einen Tab |
Zugriff durch JavaScript möglich; nicht für Zugangsdaten, Token oder sensible fachliche Daten verwenden |
|
Nicht sensible Benutzereinstellungen, zum Beispiel UI-Präferenzen |
Persistiert über Sitzungen hinweg; Zugriff durch JavaScript möglich; nicht für sensible Daten verwenden |
|
Größere strukturierte Datenmengen, zum Beispiel fachlich begründete Offline-Szenarien |
Nur mit explizitem Konzept für Datenschutz, Löschung, Versionierung und Validierung verwenden |
Cookies |
Nur für klar definierte technische Zwecke, insbesondere im Rahmen des abgestimmten Sicherheitskonzepts |
Fachliche Anwendungsdaten SOLLEN nicht in Cookies gespeichert werden |
Sensible Daten DÜRFEN grundsätzlich NICHT in localStorage, sessionStorage oder IndexedDB gespeichert werden.
Dazu zählen insbesondere Zugangsdaten, Session-IDs, Tokens, personenbezogene Daten mit erhöhtem Schutzbedarf, Berechtigungsinformationen und fachlich besonders schützenswerte Daten.
Daten aus clientseitiger Speicherung MÜSSEN beim Lesen als nicht vertrauenswürdig behandelt werden. Sie können durch Benutzer, Browser-Erweiterungen oder Schadcode verändert worden sein. Deshalb MÜSSEN gespeicherte Daten validiert und bei fachlicher Relevanz serverseitig erneut geprüft werden.
Für persistierte Client-Daten SOLLEN Versionierung, Migration und Löschung berücksichtigt werden. Nicht mehr benötigte Daten MÜSSEN entfernt werden, insbesondere bei Logout, Benutzerwechsel oder Änderung des fachlichen Kontextes.
7.5. Umgang mit State-Management-Frameworks
Ein zusätzliches State-Management-Framework SOLL nur eingesetzt werden, wenn der Nutzen die zusätzliche Komplexität rechtfertigt. Dies kann insbesondere der Fall sein bei komplexem fachlichem Zustand, mehreren beteiligten Features, aufwendiger asynchroner Orchestrierung, Bedarf an Debugging-Werkzeugen oder einheitlichen Patterns für große Teams.
Für einfache lokale oder feature-nahe Zustände SOLLEN leichtgewichtige Mechanismen bevorzugt werden, zum Beispiel Komponenten-State, reaktive Framework-Mechanismen wie Signals bei Angular-Anwendungen oder fachlich gekapselte Services. Dadurch bleibt die Architektur verständlich und vermeidet unnötigen Boilerplate-Code.
8. UX, UI & Accessibility
Die Gestaltung der Frontends folgt verbindlichen Leitlinien zu User Interface (UI), User Experience (UX) sowie zur Barrierefreiheit. Diese Rahmenvorgaben sind im Bedienkonzept umfassend beschrieben. Darin finden sich sowohl UI/UX-Richtlinien für Bedienelemente, Fenstertypen und Layoutstrukturen als auch zentrale Anforderungen zur Barrierefreiheit. Insbesondere werden relevante Akzeptanzkriterien der WCAG 2.2 berücksichtigt, um sicherzustellen, dass alle Anwendungen für Nutzende mit unterschiedlichen Fähigkeiten uneingeschränkt und normkonform zugänglich sind.
9. Logging, Monitoring & Telemetrie
Dieses Kapitel beschreibt verbindliche Leitlinien für Logging, Monitoring und Telemetrie in Frontends. Ziel ist es, technische Fehler und Qualitätsprobleme im Betrieb nachvollziehbar zu machen, ohne personenbezogene, sicherheitsrelevante oder unnötige Daten aus dem Browser zu übertragen.
Die Vorgaben aus dem Abschnitt „Datenschutz & Datenminimierung im Browser“ gelten ergänzend. Clientseitige Telemetrie ersetzt weder das serverseitige Logging noch das Monitoring der Backend-Systeme. Sie ergänzt diese um Informationen, die ausschließlich im Browser verfügbar sind.
9.1. Ziele und Abgrenzung
Logging, Monitoring und Telemetrie erfüllen unterschiedliche Aufgaben:
-
Logging erfasst einzelne technische Ereignisse und Fehler.
-
Monitoring bewertet den Betriebszustand anhand zusammengeführter Messwerte und definierter Schwellwerte.
-
Telemetrie im Frontend bezeichnet die strukturierte Übermittlung technischer Ereignisse und Messwerte aus dem Frontend.
Die Browser-Konsole ist kein zentraler Logging-Dienst.
Ausgaben über console.log, console.warn oder console.error DÜRFEN NICHT ungefiltert an ein Backend oder einen Telemetrie-Dienst weitergeleitet werden.
Debug- und Entwicklungsinformationen DÜRFEN in Produktivumgebungen nicht dauerhaft aktiviert sein.
Die folgenden Vorgaben beziehen sich primär auf Single-Page Applications (SPA). Für serverseitig gerenderte oder hybride Frontend-Architekturen gelten sie sinngemäß, soweit nicht anders angegeben.
9.2. Erfassung von Fehlern in der SPA
Eine SPA SOLL nur solche technischen Fehler zentral erfassen, die für die Bewertung der Stabilität, Verfügbarkeit oder Nutzbarkeit der Anwendung relevant sind.
Hierzu zählen insbesondere:
-
unbehandelte Laufzeitfehler und unbehandelte Promise-Abweisungen,
-
Fehler beim Starten oder Initialisieren der Anwendung,
-
Fehler beim Laden kritischer JavaScript-, CSS- oder Konfigurationsressourcen,
-
fehlgeschlagene API-Aufrufe, sofern sie einen fachlichen Ablauf oder eine zentrale Funktion beeinträchtigen,
-
Fehler beim Laden dynamischer Module oder Remote-Komponenten,
-
wiederkehrende technische Fehler, die auf eine fehlerhafte Frontend-Version oder eine Störung angebundener Systeme hinweisen.
Erwartete fachliche Fehler und reguläre Benutzereingaben SOLLEN nicht als technische Fehler gemeldet werden. Hierzu zählen beispielsweise Validierungsfehler, fachlich erwartete Ablehnungen, bewusst abgebrochene Vorgänge oder fehlende optionale Eingaben.
HTTP-Statuscodes MÜSSEN fachlich eingeordnet werden.
Insbesondere DÜRFEN NICHT alle Antworten mit einem Statuscode aus dem Bereich 4xx pauschal als technische Fehler behandelt werden.
Ein erfasstes Fehlerereignis SOLL mindestens folgende strukturierte Angaben enthalten:
-
technische Fehlerkategorie und stabiler Fehlercode,
-
Schweregrad,
-
Zeitpunkt,
-
Anwendung und Anwendungsversion,
-
Umgebung,
-
betroffene Funktion oder abstrahierte Route,
-
Ergebnis der betroffenen technischen Operation,
-
Korrelations-ID, sofern verfügbar.
Vollständige URLs, Request- und Response-Inhalte, Formulardaten, Tokens, Session-Informationen und andere personenbezogene oder sicherheitsrelevante Daten DÜRFEN NICHT Bestandteil des Fehlerereignisses sein.
Stacktraces DÜRFEN nur übertragen werden, wenn sie vor der Übermittlung bereinigt und auf notwendige technische Informationen begrenzt wurden. Quellcode, Zugangsdaten, Inhalte aus Benutzereingaben oder interne Infrastrukturinformationen DÜRFEN dadurch nicht offengelegt werden.
9.3. Übermittlung von Fehler- und Telemetriedaten
Fehler- und Telemetriedaten MÜSSEN strukturiert über eine definierte und versionierte HTTPS-Schnittstelle übertragen werden. Die ungefilterte Übertragung von Konsolenausgaben oder beliebigen JavaScript-Objekten ist nicht zulässig.
Die Schnittstelle MUSS insbesondere folgende Maßnahmen unterstützen:
-
Validierung des Datenformats,
-
Begrenzung der Größe einzelner Ereignisse und Übertragungen,
-
Filterung oder Verwerfung unzulässiger Inhalte,
-
Begrenzung der Übertragungsrate,
-
Schutz vor missbräuchlicher oder automatisierter Übermittlung,
-
Zuordnung zu Anwendung, Version und Umgebung,
-
kontrollierte Weiterleitung an die zentrale Logging- und Monitoring-Infrastruktur.
Telemetrie-Endpunkte DÜRFEN NICHT als allgemeine Proxy-Schnittstelle zu externen Monitoring-Diensten verwendet werden.
Übertragungsfehler DÜRFEN die eigentliche Nutzung der Anwendung nicht blockieren. Wiederholungsversuche MÜSSEN zeitlich und mengenmäßig begrenzt werden.
Eine dauerhafte Speicherung von Telemetriedaten im Browser SOLL vermieden werden. Insbesondere fehlgeschlagene Übertragungen DÜRFEN NICHT zu einer unkontrollierten persistenten Sammlung von Fehlerdaten führen.
9.4. Monitoring und Performance-Metriken
Frontends SOLLEN technische Metriken erfassen, wenn diese zur Bewertung von Stabilität, Verfügbarkeit und wahrgenommener Performance benötigt werden.
Geeignete Metriken sind insbesondere:
-
Dauer bis zur initialen Nutzbarkeit der Anwendung,
-
Lade- und Darstellungszeiten zentraler Ansichten,
-
Reaktionszeiten auf relevante Benutzerinteraktionen,
-
Dauer und Fehlerquote von API-Aufrufen,
-
Anzahl unbehandelter Frontend-Fehler,
-
Fehlerquote beim Laden kritischer Ressourcen oder dynamischer Module,
-
technische Abbruchquote zentraler Anwendungsabläufe,
-
Verteilung der eingesetzten Anwendungsversionen.
Metriken SOLLEN aggregiert ausgewertet werden. Einzelne Messwerte DÜRFEN NICHT ohne fachliche und datenschutzrechtliche Begründung einem konkreten Benutzer zugeordnet werden.
Metriken MÜSSEN mindestens nach Anwendung, Version und Umgebung unterscheidbar sein. Weitere Dimensionen, beispielsweise Browserfamilie oder Gerätetyp, DÜRFEN nur in der für die technische Analyse erforderlichen Genauigkeit übertragen werden.
Für relevante Metriken SOLLEN Zielwerte, Warnschwellen und Alarmierungsregeln definiert werden. Alarmierungen SOLLEN auf aggregierten und wiederholt auftretenden Problemen basieren und nicht unkontrolliert für jedes einzelne Client-Ereignis ausgelöst werden.
Neben der realen Nutzung SOLLEN für geschäftskritische Frontends synthetische Prüfungen berücksichtigt werden. Diese können beispielsweise die Erreichbarkeit, den erfolgreichen Anwendungsstart und zentrale technische Abläufe überprüfen.
9.5. Korrelation und Nachvollziehbarkeit
Fehler und Messwerte SOLLEN einer technischen Benutzeraktion oder Backend-Anfrage zugeordnet werden können, ohne personenbezogene Daten zu verwenden.
Für HTTP-Anfragen ist die in der Referenzarchitektur REST definierte Korrelations-ID im Header X-Correlation-Id zu berücksichtigen.
Vorhandene Korrelationsinformationen SOLLEN bei der Kommunikation zwischen Frontend, Backend-for-Frontend und Backend weitergegeben werden, soweit dies technisch und sicherheitlich vorgesehen ist.
Vom Browser übermittelte Korrelations-IDs MÜSSEN als nicht vertrauenswürdig behandelt werden. Sie DÜRFEN NICHT als Grundlage für Autorisierung, Zugriffskontrolle oder andere sicherheitsrelevante Entscheidungen verwendet werden.
Ein Backend-for-Frontend SOLL eingehende IDs validieren oder eigene vertrauenswürdige Korrelationsinformationen erzeugen. Die Zuordnung zwischen einem clientseitigen Ereignis und den zugehörigen serverseitigen Logs SOLL anschließend in der zentralen Observability-Infrastruktur möglich sein.
9.6. Berücksichtigung des Backend-for-Frontend
Bei Verwendung eines Backend-for-Frontend SOLL dieses als zentrale Annahmestelle für Frontend-Fehler und Telemetriedaten vorgesehen werden.
Das Backend-for-Frontend SOLL insbesondere:
-
eine gleichartige, vorzugsweise Same-Origin-basierte Schnittstelle für die SPA bereitstellen,
-
eingehende Ereignisse anhand eines definierten Schemas validieren,
-
sensible oder unzulässige Inhalte filtern,
-
Größen- und Ratenbegrenzungen durchsetzen,
-
Anwendung, Version, Umgebung und technischen Kontext ergänzen,
-
Korrelationsinformationen erzeugen oder validieren,
-
Daten kontrolliert an zentrale Logging-, Monitoring- oder Tracing-Systeme weiterleiten.
Benutzer- oder Sitzungsinformationen, die serverseitig bereits vorliegen, SOLLEN nicht zusätzlich durch das Frontend übertragen werden. Das Backend-for-Frontend DARF diese Informationen nur ergänzen, wenn dies für den festgelegten technischen Zweck erforderlich und datenschutzrechtlich zulässig ist.
Ohne Backend-for-Frontend MUSS eine vergleichbare abgesicherte Telemetrie-Schnittstelle über das API-Gateway oder eine dafür vorgesehene Backend-Komponente bereitgestellt werden. Eine direkte Kopplung der SPA an interne Logging-Systeme ist nicht zulässig.